借助 Amazon DynamoDB 新功能,升级你的 AI 驱动游戏后端
Level up your AI-powered game backend with Amazon DynamoDB new features
文章把跨区强一致、零 ETL 与 Agent 检查点组合成游戏后端架构,便于评估 AI NPC 状态如何落地。
在将 AI 用于游戏时,最困难的工程问题并不是选择正确的模型——而是选择能够支持创造引人入胜的用户体验所需功能的基础设施。一个会忘记每一次对话的生成式非玩家角色(NPC)、一个在任务中途丢失叙事上下文的 AI 地下城主,或者一个在 AWS Lambda 冷启动期间丢失状态的智能体循环,都会因为同样的原因产生欠佳的体验:缺少持久、全局一致的状态存储层。
对于大多数生产环境的游戏后端而言,这一存储层已经是 Amazon DynamoDB,它以每秒数百万次请求的规模处理库存、排行榜、玩家档案和会话状态。在过去 12–18 个月里,DynamoDB 推出了四项改进,直接推动 AI 原生游戏后端的发展:
- 面向全球玩家状态的全局强一致性
- 零提取、转换和加载(ETL)管道,为机器学习(ML)训练和实时分析提供数据
- 通过 LangGraph DynamoDBSaver 连接器实现持久化的智能体状态
- 按需吞吐量降价 50%,重塑无服务器游戏基础设施的经济性。
本文会逐一介绍这些改进——并配合针对游戏的示例——同时演示如何将它们串联成一个现代 AI 游戏后端。
多区域强一致性
全局表长期以来提供跨多个 AWS 区域的最终一致性复制,这对于排行榜来说可以接受,但对于付费货币或 AI 智能体状态则不行。如果一名玩家在 us-east-1 消耗了宝石,而几毫秒后一个 AI 任务事件从 us-west-2 读取其余额,过期的读取可能导致余额变为负数或重复发放物品。
多区域强一致性(MRSC)——于 2025 年正式可用——解决了这个问题。写入在返回成功之前会同步复制到至少另一个区域,并且保证从任意副本进行的 ConsistentRead=True 都会返回最新版本。ConsistentRead=True 是 DynamoDB API 参数,指示服务返回某个项最近写入的版本,无论由哪个副本处理请求;这有助于确保货币余额和代理检查点的正确性,代价是带来有界的个位数毫秒级延迟开销,玩家无法感知。后端使用的机制是一个多区域日志,这是一个跨越三个区域的仅追加日志,其中变更在三个节点中的两个执行提交后才被确认。witness 选项(一个不提供读取服务的轻量级仲裁节点)让你以更低的存储成本满足三节点要求。请参阅 使用 AWS SDK 创建和管理具有多区域强一致性的 DynamoDB 全局表,了解涵盖 MRSC 全局表设置和管理的代码示例。
MRSC 对两类游戏数据最为重要:一类是事务性数据,在这类数据中,过期读取会带来涉及真实资金的后果(付费货币、战利品箱发放、战斗通行证购买);另一类是 AI 代理状态,在这类状态中,代理在不同区域恢复运行时必须精确恢复到其上一次检查点。例如跨区域货币交易:在巴黎进行的一次宝石购买,必须保证在奖励发放前可在法兰克福看到;又如分布式 AI 代理状态:游戏主持人代理在故障后于不同区域恢复运行时,始终能精确恢复到其上一次检查点。
下图展示了 DynamoDB MRSC 如何保证对高级货币余额、agent 状态和库存的写入,在向调用方返回成功之前,使用多区域日志在欧盟区域集的所有三个节点(爱尔兰、巴黎和法兰克福)上同步提交。
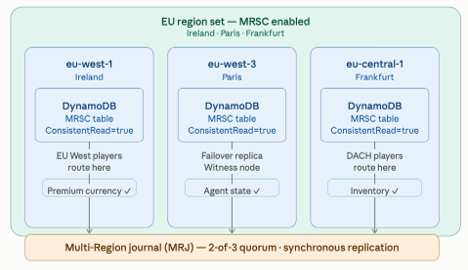
图 1 – 范围限定为欧盟区域集的 MRSC
生存时间(TTL)或本地二级索引(LSIs)在 MRSC 下不受支持。请围绕全局二级索引(GSIs)设计你的 MRSC 表;如果你需要让旧的 agent 状态自动过期,就使用条件写入或清理 Lambda 函数来实现你自己的过期逻辑。此外,MRSC 目前仅在已定义的区域集内受支持:美国(弗吉尼亚北部、俄亥俄、俄勒冈)、欧洲(爱尔兰、伦敦、巴黎、法兰克福)和亚太(东京、首尔、大阪)。目前尚不支持跨大洲强一致性,因此请将你的 MRSC 表部署在距离你的玩家群体最近的区域集内。
对于拥有真正全球化玩家群体、且玩家分布在横跨多个大洲的 Region set 的工作室,应在每个 Region set 内使用 MRSC,而对跨大洲读取(例如全球排行榜)则回退到最终一致性。请设计好路由,使高级货币和 agent 状态操作始终在单个 Region set 内完成解析。此外,事务操作(TransactWriteItems, TransactGetItems)在多区域最终一致性(MREC)表上仅在发起调用的 Region 内具有原子性,而在 MRSC 表上完全不受支持。对于需要多项目原子性的操作,请使用支持完整事务功能的单区域 DynamoDB 表。
与 Amazon SageMaker Lakehouse 的 Zero-ETL 集成
如果你是游戏分析管道的新手,请参阅 Guidance for Game Analytics Pipeline on AWS,了解基于流的架构入门指南。过去,要把 DynamoDB 数据移入训练或分析管道,意味着在编写一行 ML 代码之前,得先把 DynamoDB Streams、Lambda,或者 AWS Glue、Amazon Simple Storage Service(Amazon S3)、AWS Glue Data Catalog 和 Amazon Athena 串联起来。在 re:Invent 2024 上推出的与 Amazon SageMaker Lakehouse 的零 ETL 集成消除了这一步骤。使用 AWS Glue 的 AWS 管理控制台配置一次,DynamoDB 就会以 Apache Iceberg 格式将你的表复制到 SageMaker Lakehouse 中,并自动完成 Data Catalog 注册,以及基于变更数据捕获(CDC)的增量同步,通常只需几分钟。此后,SageMaker 工具便可以查询你的运营游戏数据、在其上进行训练,并基于这些数据提供洞察;这一切都不会影响你生产环境中的 DynamoDB 工作负载,也不会消耗任何表的读容量。
对于在线服务型游戏,这意味着会话级玩家行为、AI NPC 交互和道具经济数据会自动流入一种格式,数据科学家可以在其中查询并训练仅几分钟前(而非几小时前)的数据。实用模式包括 NPC 对话质量评估、持续个性化模型再训练、游戏平衡分析,以及结合运营数据与历史数据的作弊检测。
下图展示了用 Zero-ETL 集成替换自定义的多服务 ETL 管道,如何简化从 DynamoDB 游戏会话数据到 SageMaker 机器学习工作负载的路径。
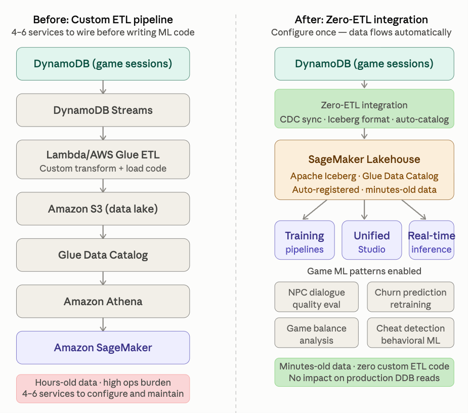
图 2 – 自定义 ETL 管道与 Zero-ETL 集成的前后对比
设置需要在源表上启用 PITR,配置授予 AWS Glue 导出权限的基于角色的访问控制(RBAC)策略,并通过 AWS Glue 控制台创建该集成;随后查询可直接在 SageMaker Unified Studio 中针对实时同步的 Lakehouse 表运行。详情请参阅 DynamoDB 与 Amazon SageMaker Lakehouse 的 zero-ETL 集成。
DynamoDB 作为 AI 代理的记忆层 – LangGraph DynamoDBSaver
AI 智能体——即由机器学习支持、能够自主串联工具调用、分支逻辑和多步推理以完成目标的系统——默认是无状态的。每一次 Lambda 冷启动、玩家重连或跨服务交接都会丢失状态,除非你已经构建了持久化层。langgraph-checkpoint-aws 库为 LangGraph 智能体提供了一个生产就绪的 DynamoDB 检查点后端。
DynamoDBSaver 将检查点元数据和智能体状态(对话历史、工具结果、NPC 关系分数以及进行中的任务上下文)存储在 DynamoDB 中,并自动将超过 350 KB 的负载卸载到 Amazon S3,无需任何应用路由代码——远早于 DynamoDB 400 KB 的单条目上限。每个玩家会话都会获得一个唯一的 thread_id;智能体在重新连接时从精确的状态恢复。有关实现细节,请参阅使用 DynamoDB 作为 LangGraph 智能体的检查点存储。
这解锁了三种游戏模式:
- 一个具有持久记忆的 NPC。设想一位玩家在三个场次之前帮助过的铁匠。没有 DynamoDBSaver,铁匠会像对待陌生人一样迎接他们。有了它,智能体会在会话开始时加载完整的对话历史和关系评分,铁匠的开场白会反映他们的过往:“我记得你。”
- 一个 AI 地下城主,在断线后能从遭遇战中途继续,而无需重放已完成的步骤,因为确切的智能体检查点始终可以从 DynamoDB 恢复。
- 人在回路的内容审核,其中智能体在审核节点暂停,等待异步批准信号,而这在没有持久状态的情况下是不可能的。
价格降低与热吞吐量
2024年11月1日,AWS 将 DynamoDB 按需吞吐量定价降低了50%,并将全局表复制写入定价最高降低了67%。这实质上改变了按需容量与预置容量之间的盈亏平衡点。对于波动较大的游戏工作负载——尤其是那些因 AI 推理调用而产生不可预测写入突发的负载——现在推荐默认使用按需容量。
为便于理解:一款中型在线服务型游戏每天跨两个全球表副本写入 1000 万个条目,此前每百万复制写入请求单元(WRUs)约支付 1.25 美元。按新定价,相同工作负载每百万 WRUs 的成本约为 0.625 美元,每月可节省约 6,250 美元,即每年节省 75,000 美元,且无需更改架构。对于大规模运行 AI 智能体检查点保存的工作室而言,写入量会随智能体交互频率增加,节省还会进一步叠加。
DynamoDB 预热吞吐量使表能够立即承接高达预先设定的峰值水平的流量,不过实际性能可能因热分区、预置容量设置或配置的按需限制而有所不同。有关更多信息,请参阅在不同场景中理解 DynamoDB 预热吞吐量。
参考架构
本文所述的四项功能组合成一个连贯的技术栈。使用一张 DynamoDB 表,以 player_id 作为分区键、record_type 作为排序键,将档案、物品栏、智能体检查点、NPC 关系评分和对话历史全部放在同一张表中,通过一次 GetItem 调用或定向查询即可获取。
为每个 Region 集部署独立的启用 MRSC 的表。使用 ConsistentRead=True 处理货币和代理检查点加载,并对排行榜和非关键属性使用最终一致性读取。在游戏会话表上启用指向 SageMaker Lakehouse 的 zero-ETL,并每周重新训练个性化模型,将更新后的嵌入写回 DynamoDB 以进行实时推理。按新定价以按需模式运行所有表;在重大活动前预热到预期峰值的 2 倍。
下图展示了四项 DynamoDB 功能——单表设计、MRSC 读一致性、与 SageMaker Lakehouse 的 Zero-ETL 集成以及按需定价——如何组合成一个连贯的 AI 游戏后端技术栈,其中所有受 MRSC 治理的记录类型共用一张表,而游戏会话表则作为 ML 流水线的专用 zero-ETL 数据源。
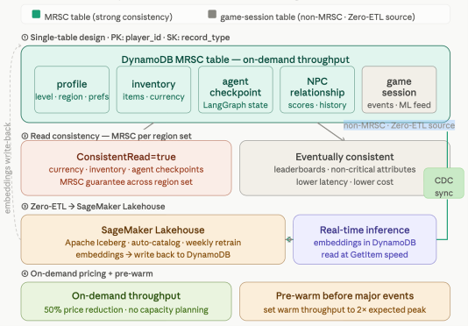
图 3 – AI 游戏后端的 DynamoDB 参考架构
结论
DynamoDB 如今不再只是用于排行榜和玩家档案的数据库。多区域强一致性使全局一致的智能体状态变得切实可行。Zero-ETL 集成无需自定义基础设施即可为 ML 流水线提供数据。LangGraph 检查点使持久化 AI 智能体只需集成一个库即可实现。而 2024 年的降价让几乎所有规模的工作室都能使用这一切。最出色的 AI 驱动游戏体验需要一个数据层:速度足够快,不会增加推理延迟;可扩展性足够强,能够吸收爆红流量峰值;持久性足够高,能够将智能体状态视为关键数据。有了这些新增功能,DynamoDB 正是这样的数据层。
资源与后续步骤
来源:AWS for Games · 游戏技术与运营 · aws.amazon.com